

ভিডিও টিউটোরিয়াল (পর্ব ১): Probabilistic Classifier ও Naive Bayes
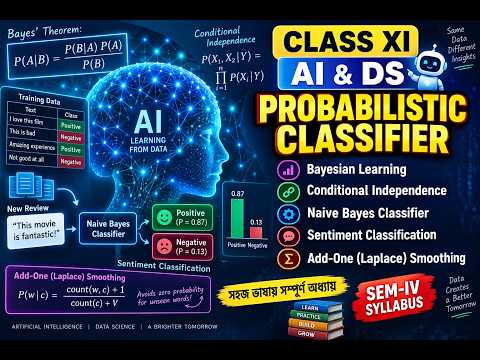
Supervised Learning- Probabilistic Classifier
1. Probabilistic Classifier ও Bayesian Learning-এর মূল ধারণা
একটি সাধারণ ক্লাসিফায়ার সরাসরি বলে দেয় ডেটা পয়েন্টটি কোন ক্লাসের (যেমন: “Spam” নাকি “Ham”)। কিন্তু Probabilistic Classifier শুধু লেবেল দেয় না, বরং নির্দিষ্ট ক্লাস হওয়ার সম্ভাবনা বা probability হিসাব করে: P(Y | X)। যার probability সবচেয়ে বেশি, তাকেই প্রেডিক্ট করা হয়।
সাধারণ ক্লাসিফায়ার বনাম প্রোবাবিলিস্টিক ক্লাসিফায়ার
| বৈশিষ্ট্য | সাধারণ (Deterministic) Classifier | Probabilistic Classifier |
|---|---|---|
| আউটপুট | সরাসরি ক্লাসের নাম (যেমন: Pass অথবা Fail)। | প্রতিটি ক্লাসের সম্ভাবনা (যেমন: Pass: 0.85, Fail: 0.15)। |
| অনিশ্চয়তা পরিমাপ | সিদ্ধান্তটি কতটা ঝুঁকিপূর্ণ তা বোঝা যায় না। | প্রোবাবিলিটি দেখে বোঝা যায় মডেলটি কতটা আত্মবিশ্বাসী (যেমন 0.51 বনাম 0.99)। |
Basics of Bayesian Learning
এটি মূলত Bayes’ Theorem-এর ওপর দাঁড়িয়ে রয়েছে। নতুন কোনো ডেটা বা evidence (X) পাওয়ার পর আমাদের পূর্ববর্তী বিশ্বাস বা hypothesis (Y) কীভাবে আপডেট হয়, সেটাই এর মূল কথা:
- Prior Probability P(Y): নতুন কোনো তথ্য পাওয়ার আগে আমাদের প্রাথমিক ধারণা (যেমন: সাধারণভাবে কোনো রোগের প্রকোপ কতটা)।
- Likelihood P(X | Y): ক্লাস Y সত্যি হলে এই লক্ষণ বা feature X দেখা যাওয়ার সম্ভাবনা কতটা।
- Posterior Probability P(Y | X): লক্ষণ X দেখার পর নির্দিষ্ট ক্লাস Y হওয়ার চূড়ান্ত সম্ভাবনা।
- Evidence P(X): সব মিলিয়ে ডেটা X ঘটার মোট সম্ভাবনা (normalizing constant)।
রিয়েল-লাইফ উদাহরণ (Medical Diagnostic):
ধরুন, কোনো এলাকায় ডেঙ্গু হওয়ার সাধারণ সম্ভাবনা মাত্র 1% (P(Dengue) = 0.01)।
- একটি ডায়াগনস্টিক টেস্ট ডেঙ্গু থাকলে 95% ক্ষেত্রে সঠিক পজিটিভ রেজাল্ট দেয় (P(Positive | Dengue) = 0.95)।
- কিন্তু সুস্থ মানুষের ক্ষেত্রেও ভুল করে 5% সময়ে পজিটিভ রিপোর্ট আসে (False Positive, P(Positive | No Dengue) = 0.05)।
- যদি একজন ব্যক্তির টেস্ট রেজাল্ট পজিটিভ আসে, তবে তার আসলেই ডেঙ্গু হয়েছে কিনা P(Dengue | Positive) তা হিসাব করতে Bayes’ Theorem প্রয়োজন। দেখা যাবে, রোগের সামগ্রিক হার (prior) কম থাকায় টেস্ট পজিটিভ হলেও আসল সম্ভাবনা খুব একটা বেশি নয় (প্রায় 16%)।
2. Conditional Independence (শর্তসাপেক্ষ স্বাধীনতা)
দুটি ভ্যারিয়েবল X1 এবং X2 তখনই তৃতীয় কোনো ভ্যারিয়েবল Y-এর ওপর Conditionally Independent হবে, যদি Y-এর মান জানা হয়ে গেলে X2-এর তথ্য X1 সম্পর্কে নতুন কোনো সাহায্য না করে:
রিয়েল-লাইফ উদাহরণ:
ধরি, Y = প্রচণ্ড ঝড়-বৃষ্টি, X1 = বাড়ির সামনের রাস্তা ভেজা, এবং X2 = রাস্তায় ট্রাফিক জ্যাম।
- সাধারণ অবস্থায় সামনের রাস্তা ভেজা দেখলে মনে হতে পারে রাস্তায় জ্যাম থাকার সম্ভাবনা বেশি (কারণ দুটোই খারাপ আবহাওয়ার সাথে সম্পর্কযুক্ত, অর্থাৎ তারা dependent)।
- কিন্তু আপনি যদি আগেই জানালা দিয়ে দেখতে পান যে প্রচণ্ড ঝড়-বৃষ্টি হচ্ছে (Y জানা আছে), তবে সামনের রাস্তা ভিজেছে কি ভেজেনি—এই তথ্যটি রাস্তার ট্রাফিক জ্যাম বোঝার জন্য আলাদা করে কোনো নতুন মূল্য যোগ করে না। অর্থাৎ, ঝড়-বৃষ্টির সাপেক্ষে সামনের রাস্তা ভেজা এবং ট্রাফিক জ্যাম conditionally independent।
3. Naive Bayes Classifier
যখন কোনো ডেটাসেটে অনেকগুলো ফিচার থাকে (X1, X2, …, Xn), তখন সব ফিচারের যৌথ সম্ভাবনা বা joint probability P(X1, X2, …, Xn | Y) হিসাব করা প্রায় অসম্ভব হয়ে পড়ে।
Naive Bayes একটি অত্যন্ত সহজ বা “naive” অনুমান (assumption) করে: ক্লাস লেবেল Y জানা থাকলে সমস্ত ফিচার একে অপরের সাথে Conditionally Independent।
এই অনুমানের ফলে হিসাবটি একদম সরল হয়ে যায়:
রিয়েল-লাইফ উদাহরণ (ইমেইল স্প্যাম ফিল্টারিং)
জিমেইল বা যেকোনো ইমেইল সার্ভিস কোনো ইমেইল Spam (স্প্যাম) নাকি Ham (নিরাপদ) তা নির্ধারণ করতে Naive Bayes Classifier ব্যবহার করে।
- ট্রেনিং ও শব্দ গণনা: মডেলে আগে থেকেই প্রচুর স্প্যাম এবং হ্যাম ইমেইল জমা থাকে। Naive Bayes এই ইমেইলগুলো বিশ্লেষণ করে দেখে যে স্প্যাম ইমেইলে সাধারণত “Free”, “Win”, “Cash”, বা “Offer” শব্দগুলো কতবার আসে।
- নতুন ইমেইল পরীক্ষা: আপনার ইনবক্সে একটি নতুন ইমেইল এল যেখানে লেখা আছে: “Free cash prize!” Naive Bayes মডেলটি তখন Bayes’ Theorem ও Conditional Independence-এর সূত্র কাজে লাগিয়ে দুটি সম্ভাবনা হিসাব করে:
- P(Spam | “Free”, “cash”, “prize”) — অর্থাৎ এই শব্দগুলো থাকার কারণে ইমেইলটি স্প্যাম হওয়ার সম্ভাবনা কতটুকু।
- P(Not Spam | “Free”, “cash”, “prize”) — অর্থাৎ এটি কাজের বা নিরাপদ ইমেইল হওয়ার সম্ভাবনা কতটুকু।
- চূড়ান্ত সিদ্ধান্ত: মডেলটি প্রতিটি শব্দের পৃথক সম্ভাবনা খুব দ্রুত গুণ করে দেখে কোন ক্লাসের স্কোর বেশি। স্প্যাম হওয়ার সম্ভাবনা বেশি হলে ইমেইলটি স্বয়ংক্রিয়ভাবে স্প্যাম ফোল্ডারে চলে যায়।
ভিডিও টিউটোরিয়াল (পর্ব ২): Sentiment Analysis ও Laplace Smoothing | KNN

4. Sentiment Classification ও Add-One (Laplace) Smoothing
Sentiment Analysis-এর ক্ষেত্রে (যেমন: কোনো মুভি বা প্রডাক্ট রিভিউ Positive নাকি Negative নির্ধারণ করা) সাধারণত Bag-of-Words মডেল ব্যবহার করা হয়। এখানে বাক্যের ব্যাকরণ বাদ দিয়ে শুধু কোন শব্দ কতবার এসেছে তা গোনা হয়।
Zero-Frequency Problem
ধরুন, আপনার ট্রেনিং সেটে যত Negative রিভিউ ছিল, তার কোথাও “অসাধারণ” শব্দটি ছিল না। এখন টেস্ট করার সময় একটি নেগেটিভ রিভিউ এল: “অভিনয় ভালো হলেও গল্পটি একদম অসাধারণ ছিল না” এখন:
যেহেতু সব শব্দের সম্ভাবনা গুণ করা হয়, একটি শূন্য পুরো ফলাফলকেই শূন্য করে দেবে: P(Negative | Review) = P(Negative) × P(…) × 0 = 0। ক্লাসিফায়ার এই রিভিউটিকে কোনোভাবেই Negative হিসেবে বিবেচনা করবে না।
Add-One (Laplace) Smoothing
এই সমস্যার সমাধানে প্রতিটি শব্দের কাউন্টের সাথে কৃত্রিমভাবে 1 যোগ করা হয়:
এখানে |V| হলো পুরো ট্রেনিং ডেটাসেটের মোট ইউনিক শব্দের সংখ্যা (vocabulary size)। হরে |V| যোগ করায় মোট probability-র যোগফল সবসময় 1 থাকে। এর ফলে কোনো অজানা শব্দের সম্ভাবনা আর কখনোই শূন্য হয় না, বরং খুব ছোট একটি মান পায়।
Example 1: ইউটিউব ভিডিওর মন্তব্য বিশ্লেষণ (Add-One Smoothing সহ)
ধরা যাক আপনার YouTube চ্যানেলে Excel Tutorial-এর নিচে নিচের মন্তব্যগুলো এসেছে:
Training Data
| Comment | Class |
|---|---|
| ভিডিওটি খুব ভালো | Positive |
| দারুণ ক্লাস হয়েছে | Positive |
| অসাধারণ টিউটোরিয়াল | Positive |
| ভিডিওটি খারাপ | Negative |
| ক্লাস বুঝতে পারিনি | Negative |
Step 1: Prior Probability ও Vocabulary
মোট Comment = 5 (Positive = 3, Negative = 2)।
সব Unique Word (Vocabulary): ভিডিওটি, খুব, ভালো, দারুণ, ক্লাস, হয়েছে, অসাধারণ, টিউটোরিয়াল, খারাপ, বুঝতে, পারিনি।
ধরা যাক নতুন Comment: “ভিডিওটি অসাধারণ” — এর Sentiment Predict করতে হবে।
- Positive Class Words: ভিডিওটি, খুব, ভালো, দারুণ, ক্লাস, হয়েছে, অসাধারণ, টিউটোরিয়াল
- Negative Class Words: ভিডিওটি, খারাপ, ক্লাস, বুঝতে, পারিনি
Step 2: Add-One Smoothing প্রয়োগ ও স্কোর হিসাব
Positive Class Probability: “ভিডিওটি” (Count = 1), “অসাধারণ” (Count = 1) → Final Positive Score = 0.0066
Negative Class Probability: “ভিডিওটি” (Count = 1), “অসাধারণ” (Negative Class-এ নেই, Count = 0 → Add-One Smoothing প্রয়োগ করা হয়) → Final Negative Score = 0.0031
সিদ্ধান্ত (Classification)
| Class | Score |
|---|---|
| Positive | 0.0066 |
| Negative | 0.0031 |
অতএব, “ভিডিওটি অসাধারণ” → Positive Sentiment। (যেমন বাস্তবে Facebook Comment বা E-commerce Review Analysis-এ ব্যবহৃত হয়)।
Example 2: ইমেইল Spam বনাম Ham গাণিতিক উদাহরণ
ধাপ ১: ট্রেনিং ডেটাসেট (Training Data) তৈরি
ধরি, আমাদের কাছে আগে থেকে লেবেল করা মোট ১০টি ইমেইল আছে (6টি Ham এবং 4টি Spam):
- Ham (নিরাপদ ইমেইল – 6টি, মোট শব্দ = 18টি): (1) “meeting tomorrow office”, (2) “project report submit”, (3) “office meeting schedule”, (4) “submit project deadline”, (5) “tomorrow schedule update”, (6) “office report update”
- Spam (স্প্যাম ইমেইল – 4টি, মোট শব্দ = 12টি): (1) “win free prize”, (2) “free money offer”, (3) “win cash prize”, (4) “claim free money”
পুরো ভোকাবুলারিতে মোট ইউনিক শব্দ সংখ্যা |V| = 16 (meeting, tomorrow, office, project, report, submit, schedule, deadline, update, win, free, prize, money, offer, cash, claim)।
ধাপ ২: Prior Probability হিসাব করা
ধাপ ৩: নতুন ইমেইল টেস্ট করা (“free office prize”)
(ক) ইমেইলটি Spam হওয়ার স্কোর হিসাব (হর = 12 + 16 = 28):
- P(“free” | Spam) = (3 + 1) / 28 = 4 / 28 ≈ 0.1428
- P(“office” | Spam) = (0 + 1) / 28 = 1 / 28 ≈ 0.0357
- P(“prize” | Spam) = (2 + 1) / 28 = 3 / 28 ≈ 0.1071
(খ) ইমেইলটি Ham হওয়ার স্কোর হিসাব (হর = 18 + 16 = 34):
- P(“free” | Ham) = (0 + 1) / 34 = 1 / 34 ≈ 0.0294
- P(“office” | Ham) = (3 + 1) / 34 = 4 / 34 ≈ 0.1176
- P(“prize” | Ham) = (0 + 1) / 34 = 1 / 34 ≈ 0.0294
ধাপ ৪: তুলনা ও চূড়ান্ত সিদ্ধান্ত (Normalization)
যেহেতু Score(Spam) > Score(Ham), তাই মডেলটি ইমেইলটিকে Spam হিসেবে চিহ্নিত করবে। শতকরা (%) সম্ভাবনা:
1. Probabilistic Classifier ও Bayesian Learning-এর মূল ধারণা
একটি সাধারণ ক্লাসিফায়ার সরাসরি বলে দেয় ডেটা পয়েন্টটি কোন ক্লাসের (যেমন: “Spam” নাকি “Ham”)। কিন্তু Probabilistic Classifier শুধু লেবেল দেয় না, বরং নির্দিষ্ট ক্লাস হওয়ার সম্ভাবনা বা probability হিসাব করে: P(Y | X)। যার probability সবচেয়ে বেশি, তাকেই প্রেডিক্ট করা হয়।
সাধারণ ক্লাসিফায়ার বনাম প্রোবাবিলিস্টিক ক্লাসিফায়ার
| বৈশিষ্ট্য | সাধারণ (Deterministic) Classifier | Probabilistic Classifier |
|---|---|---|
| আউটপুট | সরাসরি ক্লাসের নাম (যেমন: Pass অথবা Fail)। | প্রতিটি ক্লাসের সম্ভাবনা (যেমন: Pass: 0.85, Fail: 0.15)। |
| অনিশ্চয়তা পরিমাপ | সিদ্ধান্তটি কতটা ঝুঁকিপূর্ণ তা বোঝা যায় না। | প্রোবাবিলিটি দেখে বোঝা যায় মডেলটি কতটা আত্মবিশ্বাসী (যেমন 0.51 বনাম 0.99)। |
Basics of Bayesian Learning
এটি মূলত Bayes’ Theorem-এর ওপর দাঁড়িয়ে রয়েছে। নতুন কোনো ডেটা বা evidence (X) পাওয়ার পর আমাদের পূর্ববর্তী বিশ্বাস বা hypothesis (Y) কীভাবে আপডেট হয়, সেটাই এর মূল কথা:
- Prior Probability P(Y): নতুন কোনো তথ্য পাওয়ার আগে আমাদের প্রাথমিক ধারণা (যেমন: সাধারণভাবে কোনো রোগের প্রকোপ কতটা)।
- Likelihood P(X | Y): ক্লাস Y সত্যি হলে এই লক্ষণ বা feature X দেখা যাওয়ার সম্ভাবনা কতটা।
- Posterior Probability P(Y | X): লক্ষণ X দেখার পর নির্দিষ্ট ক্লাস Y হওয়ার চূড়ান্ত সম্ভাবনা।
- Evidence P(X): সব মিলিয়ে ডেটা X ঘটার মোট সম্ভাবনা (normalizing constant)।
রিয়েল-লাইফ উদাহরণ (Medical Diagnostic):
ধরুন, কোনো এলাকায় ডেঙ্গু হওয়ার সাধারণ সম্ভাবনা মাত্র 1% (P(Dengue) = 0.01)।
- একটি ডায়াগনস্টিক টেস্ট ডেঙ্গু থাকলে 95% ক্ষেত্রে সঠিক পজিটিভ রেজাল্ট দেয় (P(Positive | Dengue) = 0.95)।
- কিন্তু সুস্থ মানুষের ক্ষেত্রেও ভুল করে 5% সময়ে পজিটিভ রিপোর্ট আসে (False Positive, P(Positive | No Dengue) = 0.05)।
- যদি একজন ব্যক্তির টেস্ট রেজাল্ট পজিটিভ আসে, তবে তার আসলেই ডেঙ্গু হয়েছে কিনা P(Dengue | Positive) তা হিসাব করতে Bayes’ Theorem প্রয়োজন। দেখা যাবে, রোগের সামগ্রিক হার (prior) কম থাকায় টেস্ট পজিটিভ হলেও আসল সম্ভাবনা খুব একটা বেশি নয় (প্রায় 16%)।
2. Conditional Independence (শর্তসাপেক্ষ স্বাধীনতা)
দুটি ভ্যারিয়েবল X1 এবং X2 তখনই তৃতীয় কোনো ভ্যারিয়েবল Y-এর ওপর Conditionally Independent হবে, যদি Y-এর মান জানা হয়ে গেলে X2-এর তথ্য X1 সম্পর্কে নতুন কোনো সাহায্য না করে:
রিয়েল-লাইফ উদাহরণ:
ধরি, Y = প্রচণ্ড ঝড়-বৃষ্টি, X1 = বাড়ির সামনের রাস্তা ভেজা, এবং X2 = রাস্তায় ট্রাফিক জ্যাম।
- সাধারণ অবস্থায় সামনের রাস্তা ভেজা দেখলে মনে হতে পারে রাস্তায় জ্যাম থাকার সম্ভাবনা বেশি (কারণ দুটোই খারাপ আবহাওয়ার সাথে সম্পর্কযুক্ত, অর্থাৎ তারা dependent)।
- কিন্তু আপনি যদি আগেই জানালা দিয়ে দেখতে পান যে প্রচণ্ড ঝড়-বৃষ্টি হচ্ছে (Y জানা আছে), তবে সামনের রাস্তা ভিজেছে কি ভেজেনি—এই তথ্যটি রাস্তার ট্রাফিক জ্যাম বোঝার জন্য আলাদা করে কোনো নতুন মূল্য যোগ করে না। অর্থাৎ, ঝড়-বৃষ্টির সাপেক্ষে সামনের রাস্তা ভেজা এবং ট্রাফিক জ্যাম conditionally independent।
3. Naive Bayes Classifier
যখন কোনো ডেটাসেটে অনেকগুলো ফিচার থাকে (X1, X2, …, Xn), তখন সব ফিচারের যৌথ সম্ভাবনা বা joint probability P(X1, X2, …, Xn | Y) হিসাব করা প্রায় অসম্ভব হয়ে পড়ে।
Naive Bayes একটি অত্যন্ত সহজ বা “naive” অনুমান (assumption) করে: ক্লাস লেবেল Y জানা থাকলে সমস্ত ফিচার একে অপরের সাথে Conditionally Independent।
এই অনুমানের ফলে হিসাবটি একদম সরল হয়ে যায়:
রিয়েল-লাইফ উদাহরণ (ইমেইল স্প্যাম ফিল্টারিং)
জিমেইল বা যেকোনো ইমেইল সার্ভিস কোনো ইমেইল Spam (স্প্যাম) নাকি Ham (নিরাপদ) তা নির্ধারণ করতে Naive Bayes Classifier ব্যবহার করে।
- ট্রেনিং ও শব্দ গণনা: মডেলে আগে থেকেই প্রচুর স্প্যাম এবং হ্যাম ইমেইল জমা থাকে। Naive Bayes এই ইমেইলগুলো বিশ্লেষণ করে দেখে যে স্প্যাম ইমেইলে সাধারণত “Free”, “Win”, “Cash”, বা “Offer” শব্দগুলো কতবার আসে।
- নতুন ইমেইল পরীক্ষা: আপনার ইনবক্সে একটি নতুন ইমেইল এল যেখানে লেখা আছে: “Free cash prize!” Naive Bayes মডেলটি তখন Bayes’ Theorem ও Conditional Independence-এর সূত্র কাজে লাগিয়ে দুটি সম্ভাবনা হিসাব করে:
- P(Spam | “Free”, “cash”, “prize”) — অর্থাৎ এই শব্দগুলো থাকার কারণে ইমেইলটি স্প্যাম হওয়ার সম্ভাবনা কতটুকু।
- P(Not Spam | “Free”, “cash”, “prize”) — অর্থাৎ এটি কাজের বা নিরাপদ ইমেইল হওয়ার সম্ভাবনা কতটুকু।
- চূড়ান্ত সিদ্ধান্ত: মডেলটি প্রতিটি শব্দের পৃথক সম্ভাবনা খুব দ্রুত গুণ করে দেখে কোন ক্লাসের স্কোর বেশি। স্প্যাম হওয়ার সম্ভাবনা বেশি হলে ইমেইলটি স্বয়ংক্রিয়ভাবে স্প্যাম ফোল্ডারে চলে যায়।
4. Sentiment Classification ও Add-One (Laplace) Smoothing
Sentiment Analysis-এর ক্ষেত্রে (যেমন: কোনো মুভি বা প্রডাক্ট রিভিউ Positive নাকি Negative নির্ধারণ করা) সাধারণত Bag-of-Words মডেল ব্যবহার করা হয়। এখানে বাক্যের ব্যাকরণ বাদ দিয়ে শুধু কোন শব্দ কতবার এসেছে তা গোনা হয়।
Zero-Frequency Problem
ধরুন, আপনার ট্রেনিং সেটে যত Negative রিভিউ ছিল, তার কোথাও “অসাধারণ” শব্দটি ছিল না। এখন টেস্ট করার সময় একটি নেগেটিভ রিভিউ এল: “অভিনয় ভালো হলেও গল্পটি একদম অসাধারণ ছিল না” এখন:
যেহেতু সব শব্দের সম্ভাবনা গুণ করা হয়, একটি শূন্য পুরো ফলাফলকেই শূন্য করে দেবে: P(Negative | Review) = P(Negative) × P(…) × 0 = 0। ক্লাসিফায়ার এই রিভিউটিকে কোনোভাবেই Negative হিসেবে বিবেচনা করবে না।
Add-One (Laplace) Smoothing
এই সমস্যার সমাধানে প্রতিটি শব্দের কাউন্টের সাথে কৃত্রিমভাবে 1 যোগ করা হয়:
এখানে |V| হলো পুরো ট্রেনিং ডেটাসেটের মোট ইউনিক শব্দের সংখ্যা (vocabulary size)। হরে |V| যোগ করায় মোট probability-র যোগফল সবসময় 1 থাকে। এর ফলে কোনো অজানা শব্দের সম্ভাবনা আর কখনোই শূন্য হয় না, বরং খুব ছোট একটি মান পায়।
Example 1: ইউটিউব ভিডিওর মন্তব্য বিশ্লেষণ (Add-One Smoothing সহ)
ধরা যাক আপনার YouTube চ্যানেলে Excel Tutorial-এর নিচে নিচের মন্তব্যগুলো এসেছে:
Training Data
| Comment | Class |
|---|---|
| ভিডিওটি খুব ভালো | Positive |
| দারুণ ক্লাস হয়েছে | Positive |
| অসাধারণ টিউটোরিয়াল | Positive |
| ভিডিওটি খারাপ | Negative |
| ক্লাস বুঝতে পারিনি | Negative |
Step 1: Prior Probability ও Vocabulary
মোট Comment = 5 (Positive = 3, Negative = 2)।
সব Unique Word (Vocabulary): ভিডিওটি, খুব, ভালো, দারুণ, ক্লাস, হয়েছে, অসাধারণ, টিউটোরিয়াল, খারাপ, বুঝতে, পারিনি।
ধরা যাক নতুন Comment: “ভিডিওটি অসাধারণ” — এর Sentiment Predict করতে হবে।
- Positive Class Words: ভিডিওটি, খুব, ভালো, দারুণ, ক্লাস, হয়েছে, অসাধারণ, টিউটোরিয়াল
- Negative Class Words: ভিডিওটি, খারাপ, ক্লাস, বুঝতে, পারিনি
Step 2: Add-One Smoothing প্রয়োগ ও স্কোর হিসাব
Positive Class Probability: “ভিডিওটি” (Count = 1), “অসাধারণ” (Count = 1) → Final Positive Score = 0.0066
Negative Class Probability: “ভিডিওটি” (Count = 1), “অসাধারণ” (Negative Class-এ নেই, Count = 0 → Add-One Smoothing প্রয়োগ করা হয়) → Final Negative Score = 0.0031
সিদ্ধান্ত (Classification)
| Class | Score |
|---|---|
| Positive | 0.0066 |
| Negative | 0.0031 |
অতএব, “ভিডিওটি অসাধারণ” → Positive Sentiment। (যেমন বাস্তবে Facebook Comment বা E-commerce Review Analysis-এ ব্যবহৃত হয়)।
Example 2: ইমেইল Spam বনাম Ham গাণিতিক উদাহরণ
ধাপ ১: ট্রেনিং ডেটাসেট (Training Data) তৈরি
ধরি, আমাদের কাছে আগে থেকে লেবেল করা মোট ১০টি ইমেইল আছে (6টি Ham এবং 4টি Spam):
- Ham (নিরাপদ ইমেইল – 6টি, মোট শব্দ = 18টি): (1) “meeting tomorrow office”, (2) “project report submit”, (3) “office meeting schedule”, (4) “submit project deadline”, (5) “tomorrow schedule update”, (6) “office report update”
- Spam (স্প্যাম ইমেইল – 4টি, মোট শব্দ = 12টি): (1) “win free prize”, (2) “free money offer”, (3) “win cash prize”, (4) “claim free money”
পুরো ভোকাবুলারিতে মোট ইউনিক শব্দ সংখ্যা |V| = 16 (meeting, tomorrow, office, project, report, submit, schedule, deadline, update, win, free, prize, money, offer, cash, claim)।
ধাপ ২: Prior Probability হিসাব করা
ধাপ ৩: নতুন ইমেইল টেস্ট করা (“free office prize”)
(ক) ইমেইলটি Spam হওয়ার স্কোর হিসাব (হর = 12 + 16 = 28):
- P(“free” | Spam) = (3 + 1) / 28 = 4 / 28 ≈ 0.1428
- P(“office” | Spam) = (0 + 1) / 28 = 1 / 28 ≈ 0.0357
- P(“prize” | Spam) = (2 + 1) / 28 = 3 / 28 ≈ 0.1071
(খ) ইমেইলটি Ham হওয়ার স্কোর হিসাব (হর = 18 + 16 = 34):
- P(“free” | Ham) = (0 + 1) / 34 = 1 / 34 ≈ 0.0294
- P(“office” | Ham) = (3 + 1) / 34 = 4 / 34 ≈ 0.1176
- P(“prize” | Ham) = (0 + 1) / 34 = 1 / 34 ≈ 0.0294
ধাপ ৪: তুলনা ও চূড়ান্ত সিদ্ধান্ত (Normalization)
যেহেতু Score(Spam) > Score(Ham), তাই মডেলটি ইমেইলটিকে Spam হিসেবে চিহ্নিত করবে। শতকরা (%) সম্ভাবনা:
P(Ham | Email) = 0.000061 / (0.000218 + 0.000061) ≈ 21.86%
5. Instance-Based Learning (Lazy Learning) ও KNN Classifier
মেশিন লার্নিং অ্যালগরিদম শেখার পদ্ধতির ওপর ভিত্তি করে দুই ভাগে বিভক্ত:
| বৈশিষ্ট্য | Eager Learning (যেমন: Decision Tree, Naive Bayes) | Lazy / Instance-Based Learning (যেমন: KNN) |
|---|---|---|
| Training Phase | ট্রেনিং ডেটা থেকে আগেভাগেই রুল বা ম্যাথমেটিক্যাল মডেল বানিয়ে নেয়। | কোনো মডেল বানায় না; ট্রেনিং ডেটা কেবল মেমোরিতে সেভ করে রাখে। |
| Speed | Training ধীরগতির, কিন্তু নতুন ডেটা টেস্ট করা খুব দ্রুত O(1)। | Training টাইম শূন্য, কিন্তু টেস্ট করার সময় দূরত্ব হিসাব করতে অনেক সময় লাগে O(Nd)। |
| Data Update | নতুন ডেটা এলে আবার পুরো মডেল রি-ট্রেন করতে হতে পারে। | নতুন ডেটা এলে শুধু মেমোরিতে যুক্ত করে নিলেই কাজ শেষ। |
K-Nearest Neighbor (KNN) Classifier
- যখন কোনো নতুন ডেটা পয়েন্ট Xq আসে, তখন ট্রেনিং ডেটার প্রতিটি পয়েন্টের সাথে তার দূরত্ব (Euclidean distance: √∑(xi – yi)2) মাপা হয়।
- সবচেয়ে কাছের K-সংখ্যক প্রতিবেশী (neighbors) বেছে নেওয়া হয়।
- তাদের মধ্যে যে ক্লাসের সংখ্যা সবচেয়ে বেশি (majority voting), নতুন ডেটা পয়েন্টটিকে সেই ক্লাসের অন্তর্ভুক্ত ঘোষণা করা হয়।
রিয়েল-লাইফ উদাহরণ (ব্যাংক লোন অ্যাপ্রুভাল):
একটি ব্যাংক নতুন আবেদনকারীকে লোন দেবে কিনা তা বিচার করতে তার মাসিক আয় এবং CIBIL স্কোর দেখল। KNN অ্যালগরিদম (K=5 ধরে) সবচেয়ে কাছাকাছি 5 জন পুরনো গ্রাহককে খুঁজে বের করল। দেখা গেল 4 জনই ঠিক সময়ে লোন পরিশোধ করেছেন এবং 1 জন করেননি। মেজরিটি ভোটের ভিত্তিতে নতুন গ্রাহকের লোন Approved হলো।
6. Curse of Dimensionality (মাত্রার অভিশাপ)
যখন ডেটাসেটে ফিচারের সংখ্যা বা Dimension (d) ক্রমাগত বাড়ানো হয়, তখন দূরত্বের ওপর ভিত্তি করে কাজ করা অ্যালগরিদমগুলো (যেমন KNN) মারাত্মক সমস্যার মুখে পড়ে:
- Volume বাড়ে দ্রুত, ডেটা হয়ে যায় ফাঁকা (Sparsity): ডাইমেনশন বাড়লে স্পেসের আয়তন জ্যামিতিক হারে বৃদ্ধি পায়, ফলে পুরো স্পেসটি প্রায় ফাঁকা হয়ে যায়।
- কাছের ও দূরের পার্থক্য মুছে যাওয়া: ডাইমেনশন খুব বেশি হয়ে গেলে (যেমন 500 বা 1000) যেকোনো পয়েন্ট থেকে সবচেয়ে কাছের প্রতিবেশী এবং সবচেয়ে দূরের বিন্দুর দূরত্ব প্রায় সমান হয়ে যায়: (Distancemax – Distancemin) / Distancemin → 0।
রিয়েল-লাইফ রূপক (Real-life Analogy):
- 1D (সোজা রাস্তা): 1 কিমি লম্বা রাস্তায় 100টি বাড়ি থাকলে গড়ে প্রতি 10 মিটার অন্তর একটি বাড়ি পাবেন।
- 2D (বর্গাকার জমি): ওই একই 100টি বাড়ি 1 কিমি × 1 কিমি জমিতে থাকলে দূরত্ব অনেক বেড়ে যাবে।
- 100D (100 মাত্রার স্পেস): 100 মাত্রার স্পেসে 100টি বাড়ি এত দূরে দূরে থাকবে যে কাউকে কারো “প্রতিবেশী” বলে চেনা যাবে না।
এ কারণেই হাই-ডাইমেনশনাল ডেটায় KNN ব্যবহারের আগে PCA (Principal Component Analysis)-এর মতো Dimensionality Reduction টেকনিক ব্যবহার করা হয়।
গুরুত্বপূর্ণ প্রশ্নোত্তর (Q&A)
1. Probabilistic Classifier & Bayesian Learning
Q1. Probabilistic Classifier কাকে বলে? এটি সাধারণ (Deterministic) Classifier থেকে কীভাবে আলাদা?
Ans: যে ক্লাসিফায়ার কোনো ডেটা পয়েন্টকে সরাসরি একটি ক্লাস লেবেল না দিয়ে, প্রতিটি সম্ভাব্য ক্লাসের জন্য তার Conditional Probability P(Y | X) হিসাব করে এবং সর্বোচ্চ প্রোবাবিলিটি যুক্ত ক্লাসটিকে আউটপুট দেয় (MAP rule), তাকে Probabilistic Classifier বলে। সাধারণ ক্লাসিফায়ার শুধু ক্লাসের নাম বলে (যেমন: “Spam”), কিন্তু Probabilistic Classifier তার নিশ্চয়তার মাত্রা বা confidence score দেয় (যেমন: “92% Spam”)।
Q2. Bayes’ Theorem-এর গাণিতিক সূত্রটি লেখো এবং এর ৪টি অংশের পরিচয় দাও।
Ans: সূত্রটি হলো: P(Y | X) = [ P(X | Y) · P(Y) ] / P(X)
- P(Y): Prior Probability (নতুন তথ্য জানার আগে ক্লাস Y-এর প্রাথমিক সম্ভাবনা)।
- P(X | Y): Likelihood (ক্লাস Y হলে ফিচার X পাওয়ার সম্ভাবনা)।
- P(Y | X): Posterior Probability (ফিচার X জানার পর ক্লাস Y হওয়ার চূড়ান্ত সম্ভাবনা)।
- P(X): Evidence বা Marginal Likelihood (ফিচার X ঘটার মোট সম্ভাবনা)।
Q3. Bayesian Classification-এ প্রেডিকশন করার সময় Evidence P(X) বা হর (denominator) বাদ দেওয়া হয় কেন?
Ans: কারণ সবগুলো ক্লাসের (Y1, Y2, …, Yk) জন্য P(X)-এর মান একই থাকে (constant)। আমাদের লক্ষ্য যেহেতু শুধু সর্বোচ্চ Posterior Probability যুক্ত ক্লাসটি খুঁজে বের করা, তাই ধ্রুবক P(X) দিয়ে ভাগ না করলেও ক্লাসগুলোর তুলনামূলক ক্রম (ranking) পরিবর্তিত হয় না।
Q4. MAP (Maximum A Posterior) decision rule কী?
Ans: এটি এমন একটি নিয়ম যেখানে অবজার্ভড ডেটা X-এর সাপেক্ষে যে ক্লাস Y-এর Posterior Probability P(Y | X) সবচেয়ে বেশি হয়, সেটিকে চূড়ান্ত ক্লাস হিসেবে নির্বাচন করা হয়: ŷ = argmaxy P(y) P(X | y)।
2. Conditional Independence & Naive Bayes Classifier
Q5. Conditional Independence বলতে কী বোঝায়? গাণিতিক রূপটি লেখো।
Ans: যদি কোনো তৃতীয় ভ্যারিয়েবল Y-এর মান জানা থাকার পর, ভ্যারিয়েবল X1-এর মান জানার জন্য X2-এর তথ্য আর কোনো কাজে না আসে, তবে X1 ও X2-কে Y-এর সাপেক্ষে Conditionally Independent বলা হয়। গাণিতিক রূপ: P(X1, X2 | Y) = P(X1 | Y) · P(X2 | Y)।
Q6. Naive Bayes Classifier-কে “Naive” (সরল বা বোকা) বলা হয় কেন?
Ans: কারণ এটি বাস্তব জগতের ডেটার ক্ষেত্রে একটি অত্যন্ত অবাস্তব বা সরল অনুমান করে—তা হলো “ক্লাস লেবেল দেওয়া থাকলে ডেটাসেটের প্রতিটি ফিচার একে অপরের থেকে সম্পূর্ণ স্বাধীন (Conditionally Independent)”। বাস্তবে ফিচারগুলোর মধ্যে সম্পর্ক থাকলেও Naive Bayes সেই সম্পর্ককে উপেক্ষা করে।
Q7. ফিচারগুলোর মধ্যে সম্পর্ক থাকা সত্ত্বেও Naive Bayes বাস্তবে এত ভালো কাজ করে কেন?
Ans: ক্লাসিফিকেশনের জন্য আমাদের সঠিক প্রোবাবিলিটির মান (exact probability value) জানার দরকার পড়ে না; শুধু সঠিক ক্লাসটির প্রোবাবিলিটি অন্য ক্লাসের চেয়ে বেশি হলেই চলে। ফিচারগুলোর পারস্পরিক নির্ভরতা অনেক সময় সব ক্লাসের ক্ষেত্রে সমানভাবে কাজ করে অথবা একে অপরকে কাটাকাটি করে দেয়, ফলে চূড়ান্ত র্যাঙ্কিং ঠিক থাকে।
Q8. Naive Bayes Classifier-এর দুটি প্রধান সুবিধা ও দুটি সীমাবদ্ধতা লেখো।
Ans:
- সুবিধা: (1) খুব কম ট্রেনিং ডেটায় দ্রুত কাজ করে এবং উচ্চ-মাত্রার টেক্সট ডেটার জন্য দারুণ উপযোগী। (2) অপ্রাসঙ্গিক ফিচারের প্রতি তুলনামূলকভাবে সহনশীল।
- সীমাবদ্ধতা: (1) Strong independence assumption বাস্তবে সবসময় খাটে না। (2) কোনো ক্যাটাগরির শব্দ ট্রেনিং সেটে না থাকলে Zero-Frequency Problem তৈরি হয়।
3. Sentiment Analysis & Add-One Smoothing
Q9. Sentiment Classification-এ ‘Bag-of-Words’ (BoW) মডেল কী?
Ans: এটি টেক্সট রিপ্রেজেন্টেশনের একটি পদ্ধতি যেখানে একটি বাক্য বা ডকুমেন্টের ব্যাকরণ (grammar) এবং শব্দের ক্রম (word order) সম্পূর্ণ বাদ দিয়ে, কেবল কোন শব্দটি কতবার ব্যবহৃত হয়েছে তার ফ্রিকোয়েন্সি বা কাউন্ট রাখা হয়।
Q10. Naive Bayes-এ Zero-Frequency Problem কী এবং এটি কেন ঘটে?
Ans: টেস্ট করার সময় যদি এমন কোনো নতুন শব্দ পাওয়া যায় যা ট্রেনিং ডেটাসেটের নির্দিষ্ট কোনো ক্লাসে একবারও আসেনি, তবে ওই ক্লাসের জন্য শব্দটির Likelihood P(w | C) = 0 হয়ে যায়। সব শব্দের প্রোবাবিলিটি গুণ করা হয় বলে একটি শূন্য পুরো গুণফলকেই শূন্য করে দেয়।
Q11. Add-One (Laplace) Smoothing কীভাবে Zero-Frequency সমস্যার সমাধান করে? সূত্রটি লেখো।
Ans: Laplace Smoothing-এ ভোকাবুলারির প্রতিটি শব্দের কাউন্টের সাথে কৃত্রিমভাবে 1 যোগ করা হয় যাতে কোনো শব্দের প্রোবাবিলিটি শূন্য না হয়। সূত্রটি হলো: P(wi | C) = [ Count(wi, C) + 1 ] / [ ∑w∈V Count(w, C) + |V| ]।
Q12. Laplace Smoothing-এর হরে (Denominator) |V| যোগ করা হয় কেন?
Ans: লবে প্রতিটি শব্দের জন্য 1 করে যোগ করলে মোট |V| সংখ্যক শব্দের জন্য অতিরিক্ত |V| পরিমাণ কাউন্ট তৈরি হয়। সবগুলো শব্দের প্রোবাবিলিটির যোগফল যাতে সর্বদা 1 থাকে (∑ P(wi | C) = 1), সেই ভারসাম্য বজায় রাখতেই হরে |V| যোগ করা হয়।
Q13. Text Classification-এ প্রোবাবিলিটি গুণ করার বদলে Log Probabilities যোগ করা হয় কেন?
Ans: একটি বড় ডকুমেন্টে শত শত শব্দের খুব ছোট প্রোবাবিলিটি পরপর গুণ করলে কম্পিউটারের মেমোরিতে সংখ্যাটি এত ছোট হয়ে যায় যে তা শূন্য হয়ে যেতে পারে—একে Floating-Point Underflow বলে। লগারিদম নিলে গুণফল যোগফলে পরিণত হয় (log(ab) = log a + log b), ফলে এই সমস্যা আর হয় না।
4. Instance-Based (Lazy) Learning & KNN Classifier
Q14. Lazy Learning এবং Eager Learning-এর মধ্যে মূল পার্থক্য কী?
Ans: Eager Learning (যেমন: Decision Tree, Naive Bayes) ট্রেনিং ফেজেই ডেটা থেকে একটি সাধারণ গাণিতিক মডেল তৈরি করে রাখে, তাই টেস্ট করা খুব দ্রুত হয়। Lazy Learning (যেমন: KNN) ট্রেনিং ফেজে কোনো মডেল তৈরি করে না, শুধু ডেটা মেমোরিতে জমা রাখে; নতুন টেস্ট ডেটা এলে তখনই ক্যালকুলেশন শুরু করে।
Q15. K-Nearest Neighbor (KNN) অ্যালগরিদমকে ‘Non-parametric’ এবং ‘Lazy’ বলা হয় কেন?
Ans: Non-parametric: কারণ এটি ডেটার কোনো নির্দিষ্ট ডিস্ট্রিবিউশন ধরে নেয় না এবং মডেলে প্যারামিটারের সংখ্যা ফিক্সড থাকে না। Lazy: কারণ এটি ট্রেনিং সময়ে কোনো ফাংশন শেখে না, বরং প্রেডিকশনের সময় সমস্ত ট্রেনিং ডেটা স্ক্যান করে সিদ্ধান্ত নেয়।
Q16. KNN-এ K-এর মান খুব ছোট (যেমন K=1) বা খুব বড় হলে কী সমস্যা হয়?
Ans: K খুব ছোট হলে (K=1): মডেলটি ডেটার নয়েজ বা আউটলায়ারের প্রতি অতি সংবেদনশীল হয়ে পড়ে, ফলে Overfitting ঘটে। K খুব বড় হলে: সিদ্ধান্ত নেওয়ার সময় দূরের অন্য ক্লাসের পয়েন্টগুলোও ভোট দিয়ে ফেলে, ফলে লোকাল প্যাটার্ন নষ্ট হয় এবং Underfitting ঘটে।
Q17. বাইনারি ক্লাসিফিকেশনে KNN-এ K-এর মান সাধারণত বিজোড় (Odd) সংখ্যা নেওয়া হয় কেন?
Ans: দুটি ক্লাসের মধ্যে মেজরিটি ভোটিং করার সময় যাতে সমান-সমান ভোট পড়ে টাই (tie) না হয়ে যায়, তা এড়ানোর জন্য বিজোড় সংখ্যা (যেমন K=3, 5, 7) নেওয়া হয়।
Q18. KNN অ্যালগরিদম ব্যবহারের আগে Feature Scaling (Normalization/Standardization) করা অপরিহার্য কেন?
Ans: KNN সরাসরি দূরত্ব (যেমন Euclidean distance) পরিমাপ করে। যদি একটি ফিচারের রেঞ্জ অনেক বড় হয় (যেমন: বেতন ৫০,০০০ টাকা) এবং অন্যটির রেঞ্জ খুব ছোট হয় (যেমন: বয়স ৩০ বছর), তবে বড় রেঞ্জের ফিচারটি দূরত্বের হিসাবে একচ্ছত্র প্রভাব বিস্তার করবে। তাই সব ফিচারকে একই স্কেলে আনতে Scaling জরুরি।
5. Curse of Dimensionality
Q19. ‘Curse of Dimensionality’ (মাত্রার অভিশাপ) বলতে কী বোঝায়?
Ans: ডেটাসেটে ফিচারের সংখ্যা বা Dimension (d) অতিরিক্ত বেড়ে গেলে ফিচার স্পেসের আয়তন জ্যামিতিক হারে বৃদ্ধি পায়। এর ফলে ডেটা পয়েন্টগুলো স্পেসে অত্যন্ত ছড়িয়ে-ছিটিয়ে পড়ে (sparse হয়ে যায়) এবং দূরত্ব-ভিত্তিক অ্যালগরিদমগুলোর কার্যকারিতা মারাত্মকভাবে কমে যায়—এই ঘটনাকেই Curse of Dimensionality বলে।
Q20. উচ্চ মাত্রায় (High Dimensions) KNN অ্যালগরিদম ব্যর্থ হয় কেন?
Ans: ডাইমেনশন খুব বেশি হলে যেকোনো টেস্ট পয়েন্ট থেকে তার সবচেয়ে কাছের প্রতিবেশীর দূরত্ব এবং সবচেয়ে দূরের পয়েন্টের দূরত্ব প্রায় সমান হয়ে যায়। ফলে “কাছের প্রতিবেশী” বা similarity-র ধারণাটি অর্থহীন হয়ে পড়ে এবং KNN ভুল প্রেডিকশন দেয়।
Q21. Curse of Dimensionality কাটিয়ে ওঠার দুটি উপায় লেখো।
Ans: (1) Dimensionality Reduction: PCA (Principal Component Analysis) বা LDA ব্যবহার করে কম গুরুত্বপূর্ণ ফিচার বাদ দিয়ে ডাইমেনশন কমিয়ে আনা। (2) Feature Selection: শুধুমাত্র সবচেয়ে প্রাসঙ্গিক ফিচারগুলো বেছে নেওয়া অথবা Cosine Similarity-র মতো বিকল্প দূরত্বের পরিমাপক ব্যবহার করা।